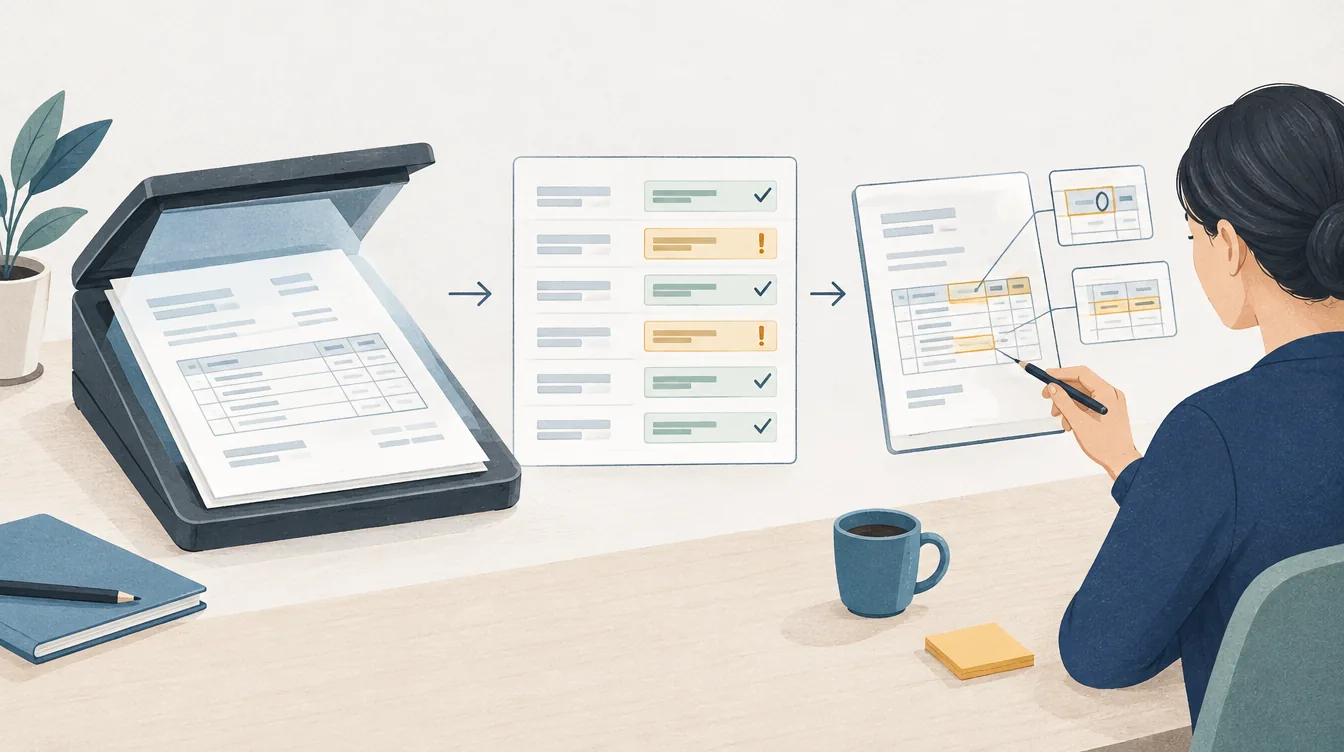
Lesbarer Text kann trotzdem falsch sein
Aus „1.280,00“ wird „128,00“, aus einem O eine Null oder aus einer Tabellenzeile die Nachbarzeile. Der exportierte Text sieht dabei oft ordentlich aus. Eine Prüfung nur darauf, ob überhaupt Text erkannt wurde, reicht daher nicht.
Trennen Sie zwei Fragen: Wurde das Zeichen richtig gelesen? Und wurde es dem richtigen Feld zugeordnet? Eine korrekt erkannte Zahl kann trotzdem als Rechnungsnummer statt als Bestellnummer erscheinen. Für den Arbeitsablauf sind beide Fehler relevant.
Kritische Felder zuerst absichern
Erstellen Sie eine Liste der Felder und der Folgen eines Fehlers. Bei einer internen Inhaltsübersicht ist ein falsch erkanntes Wort meist leichter zu korrigieren als eine falsche Menge im Bestellsystem. Leiten Sie daraus ab, welche Felder immer eine Kontrolle oder einen zusätzlichen Abgleich brauchen.
Ein Beispiel: Eine Artikelnummer wird gegen den vorhandenen Katalog geprüft. Ein Datum muss in einem plausiblen Zeitraum liegen. Positionssummen werden nachgerechnet. Diese Kontrollen erkennen manche Fehler auch dann, wenn das OCR-System selbst eine hohe Sicherheit meldet.
Was ein Konfidenzwert aussagt
Microsoft unterscheidet in der Dokumentenerkennung zwischen Konfidenz für gelesenen Text und für extrahierte Felder. Die Dokumentation empfiehlt, diese Ebenen gemeinsam zu betrachten. Hinweise zu Konfidenz und Genauigkeit.
Ein hoher Wert ist keine geschäftliche Freigabe. Legen Sie Schwellen anhand Ihrer eigenen Testdokumente und des Feldrisikos fest. Wenn ein seltenes, aber wichtiges Feld falsch erkannt wird, kann eine gute durchschnittliche Erkennungsrate diesen Mangel verdecken.
Ein Test, der Fehler sichtbar macht
Nehmen Sie neben guten Scans auch schiefe Seiten, schwachen Kontrast, mehrseitige Tabellen und handschriftliche Ergänzungen auf. Erfassen Sie die richtigen Werte unabhängig vom OCR-Ergebnis. Zählen Sie Fehler je Feldart und unterscheiden Sie nicht erkannte Angaben von falsch erkannten Angaben.
Als kleine Vorprüfung können 20 bis 30 bewusst unterschiedliche Dokumente helfen, grobe Probleme zu finden. Das ist keine statistische Zuverlässigkeitsgarantie. Für den Betrieb benötigen Sie eine zum Risiko passende, breitere Prüfung mit bisher ungesehenen Dokumenten.
Den Ursprung neben dem Ergebnis zeigen
Eine gute Prüfoberfläche öffnet die betreffende Seite und markiert möglichst die Fundstelle. Der Bearbeiter sollte nicht erst im gesamten PDF suchen müssen. Korrekturen werden mit dem Dokument verknüpft, damit wiederkehrende Probleme erkennbar bleiben.
Wenn ein Dokument unlesbar ist, kann die richtige Reaktion eine erneute Anforderung sein. Auch dieser Ausgang gehört zum Prozess. Ein plausibel ergänzter Wert ist bei kritischen Feldern kein Ersatz für eine lesbare Grundlage.
Quellen und weiterführende Grundlagen
Über den Autor
Julian Süllner hat Provehor gegründet und führt das Unternehmen als Geschäftsführer. Er verantwortet Produktentwicklung, Kundenprojekte und die Ratgeber auf dieser Website.